在数据驱动的时代,批量处理已成为处理海量数据的核心手段。无论是日志分析、数据清洗、报表生成,还是机器学习特征工程,批量处理都能以高吞吐、低成本的方式完成大规模数据转换。本文将从概念、典型架构、关键技术到最佳实践,为你系统梳理数据批量处理的全貌。
一、什么是数据批量处理?
批量处理(Batch Processing)指将数据按批次收集,在预定时间或满足条件时一次性处理。与流处理相比,批量处理不追求毫秒级延迟,但能高效利用资源处理超大规模数据集。典型场景包括:每日ETL任务、月末财务报表、全量数据 migration 等。
核心特征:
- 有界性:每次处理的数据集有明确边界。
- 离线性:通常在非高峰时段执行,减少对在线业务影响。
- 高吞吐:通过并行、分布式计算实现吞吐量最大化。
二、经典批处理架构
1. 数据采集与存储
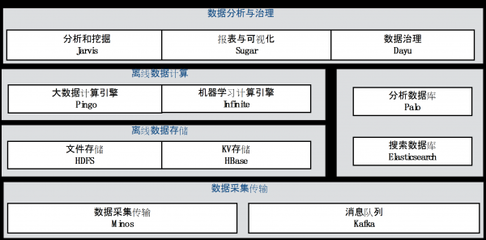
批量数据通常以文件或数据库表形式落地。常见来源包括:应用日志、数据库快照、第三方接口导出、传感器历史数据。存储层多采用分布式文件系统(如HDFS)或对象存储(如S3),配合列式格式(Parquet、ORC)提升后续处理效率。
2. 计算引擎
主流批处理引擎包括:
- Apache Hadoop MapReduce:第一代分布式批处理框架,适合超大规模离线计算,但延迟较高。
- Apache Spark:基于内存的通用计算引擎,支持SQL、流处理、机器学习,是目前批量处理的事实标准。
- Apache Flink:以流处理为核心,也提供批处理模式(DataSet API),适合批流统一场景。
3. 调度与编排
批处理任务通常按依赖关系组织成DAG(有向无环图)。调度工具如Apache Airflow、Azkaban、DolphinScheduler负责定时触发、依赖管理、失败重试与告警。
三、批量处理关键技术要点
1. 数据分区与并行度
合理分区是并行处理的基础。按时间、哈希或范围分区,确保数据均匀分布,避免数据倾斜。Spark中通过repartition或coalesce调整分区数,控制任务并行度。
2. 文件格式与压缩
列式存储(Parquet)配合压缩(Snappy、Zstd)可显著减少I/O和存储成本。对于中间数据,选择合适的分区键(如日期)可加速下游查询。
3. 容错与重试
分布式批处理必须处理节点故障。Spark通过RDD血缘(Lineage)实现重算,Hadoop通过任务重试。设计任务时应保证幂等性,即重复执行不改变结果,便于故障恢复。
4. 资源管理
使用YARN、Kubernetes等资源调度器动态分配计算资源。合理设置executor内存、核数、并发数,避免资源浪费或OOM。
四、批量处理最佳实践
- 数据质量校验前置:在批处理入口进行空值、格式、重复检查,防止脏数据扩散。
- 增量处理优先:若业务允许,尽量按时间分区增量处理,而非全量重算。
- 监控与告警:记录批次处理时长、记录数、失败率,设置阈值告警。
- 版本化与回滚:对产出数据和代码进行版本管理,保留历史快照,便于问题排查与回滚。
- 测试与并行验证:上线前用生产样本测试,新旧逻辑并行跑对拍,确保结果一致。
五、未来趋势:批流一体
随着业务对实时性要求提升,批流一体架构(如Flink、Spark Structured Streaming)逐渐普及。同一套代码可处理有界(批)和无界(流)数据,降低开发和运维成本。但在现阶段,对于超大规模、非实时场景,成熟的批处理引擎依然是最经济高效的选择。
##
数据批量处理是数据工程的基石。掌握其原理、架构与优化技巧,才能在海量数据面前游刃有余。从合理分区到资源调优,从质量保障到监控告警,每一个环节都影响着最终数据产出的效率与可靠性。希望本文能为你构建稳健的批处理系统提供清晰指引。