在当今数据驱动的时代,机器学习集成开发环境(IDE)已成为数据科学家和算法工程师的核心工具。这类环境通过整合数据处理、经典机器学习与深度学习能力,显著提升了模型开发与部署的效率。本文将探讨一个理想的机器学习IDE如何从数据处理出发,为经典机器学习和深度学习提供端到端的支持。
数据处理是机器学习工作流的基石。一个好的IDE应当内置强大的数据预处理与探索功能。用户可以直接在环境中加载多种格式的数据源,利用可视化工具进行缺失值分析、异常检测和分布统计。集成特征工程模块,支持自动化特征缩放、编码与选择,减少手动编写脚本的重复劳动。通过交互式的数据清洗管道,开发者可以实时观察每一步对数据质量的影响,确保后续建模所需的输入数据干净、一致且富有表现力。
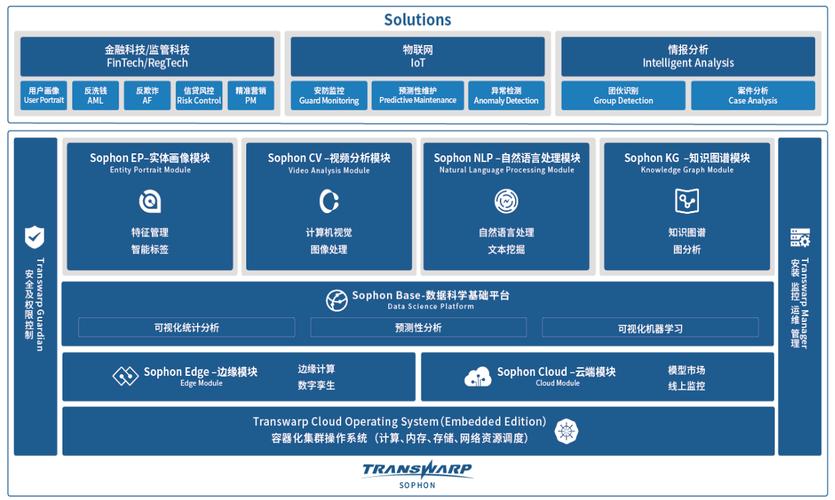
在此基础上,IDE应无缝衔接经典机器学习算法库,如scikit-learn、XGBoost等。用户无需切换工具即可完成模型选择、超参数调优与交叉验证。环境内提供统一的模型评估面板,展示准确率、召回率、ROC曲线等指标,并支持特征重要性分析与部分依赖图。对于AutoML的集成,则可进一步降低入门门槛,让开发者快速获得强基线模型,再将精力集中于业务理解与特征优化。
面向深度学习,该IDE同样需要提供友好且高效的支持。内置对PyTorch或TensorFlow的封装,允许通过可视化界面设计网络结构,或编写Python代码进行灵活定制。环境应自动处理GPU资源分配、梯度计算与训练过程监控,提供实时损失曲线与计算图查看。版本管理、实验跟踪与分布式训练的支持也不可或缺,以便团队协作比较不同网络架构与超参数组合,快速迭代模型。
更重要的是,数据处理衔接经典与深度学习的能力是IDE的差异化优势。用户可以在同一项目中定义数据加载管道与预处理函数,分别传入经典模型(如支持向量机)与深度网络(如卷积神经网络)的训练流程。统一的数据版本控制确保从数据清洗到模型部署的可复现性。结合自动化报告生成与模型导出功能,最终形成从数据输入、模型训练到结果输出的完整闭环。
理想的机器学习IDE以数据处理为起点,向下辐射经典机器学习与深度学习全链路。它通过可视化与代码互补的交互方式,降低工具切换成本,增强实验敏捷性,从而赋能开发者专注于模型设计与业务创新。随着AI工程化趋势的加速,这类集成环境将越来越成为计算智能应用落地的必备基础设施。