引言
在数字化时代,数据已经成为组织最重要的资产之一。原始数据本身几乎不具备直接价值:它可能残缺、重复、格式混乱,甚至包含误导性信息。数据处理正是将“原材料”转化为“可用产品”的关键工序。从一张表格的清洗,到大规模数据管道的运维,数据处理的深度与质量直接决定了后续分析、建模与决策的上限。
一、数据处理的定义与边界
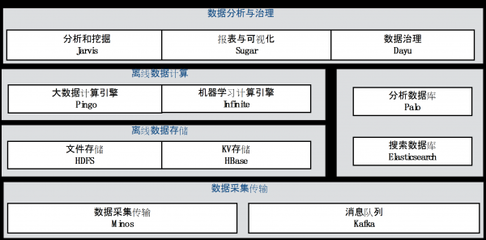
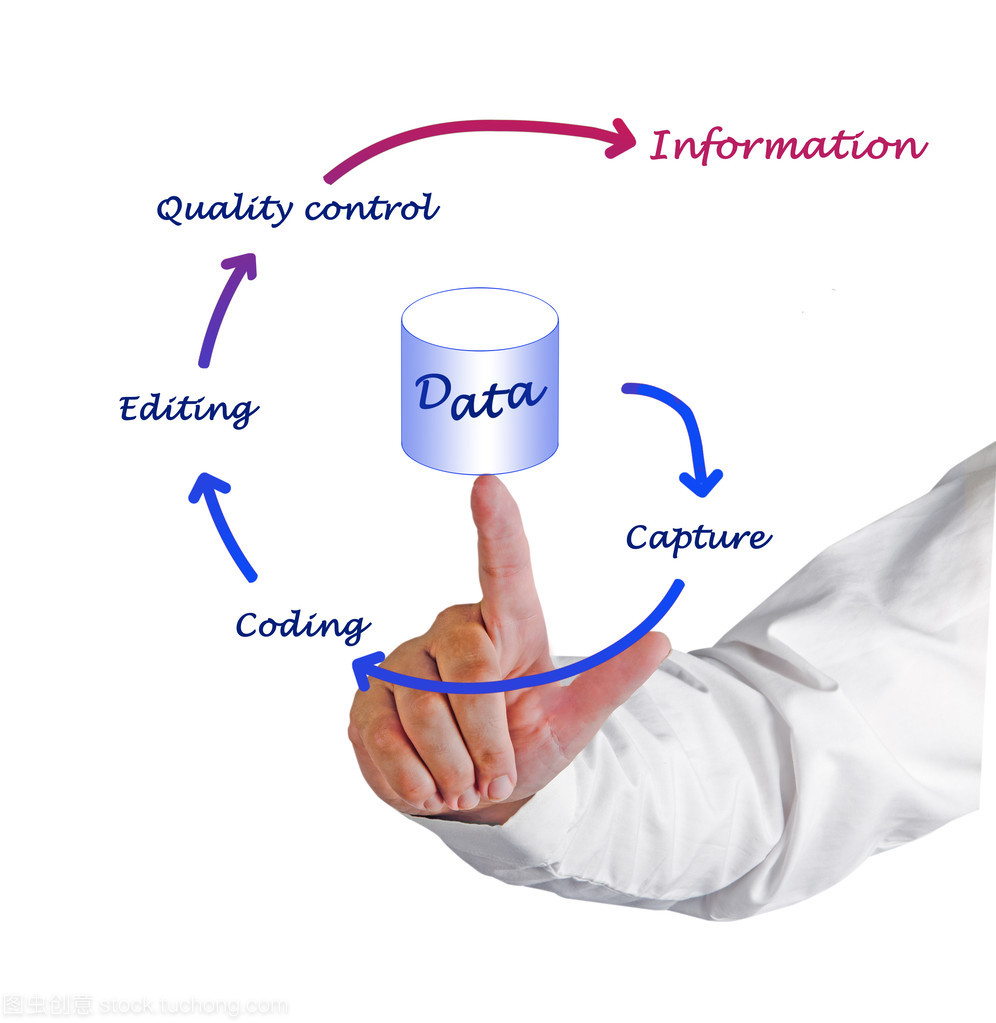
数据处理是指对原始数据进行采集、清洗、转换、整合、存储与初步汇总的一系列操作,其目标是让数据满足特定用途的质量要求与结构要求。它通常处于数据生命周期中的“治理与准备”阶段,上游对接数据采集与日志系统,下游服务统计分析、机器学习、报表与业务决策。
需要明确的是,数据处理不等于数据分析。数据分析侧重于解释与推断,而数据处理侧重于“把数据变得可用”。两者的边界虽然不绝对,但侧重点分明:前者回答“为什么”,后者回答“是什么、是否可靠、是否一致”。
二、数据处理的核心环节
1. 数据采集与接入
处理的起点是获取数据。数据可能来自业务数据库、API 接口、日志文件、传感器、第三方数据源或人工录入。接入环节需要关注:采集频率、增量与全量策略、容错与重试机制,以及数据来源的可追溯性。没有清晰来源的数据,后续的错误几乎无法定位。
2. 数据清洗
清洗是数据处理中投入最大、也最考验经验的环节,主要包括:
- 缺失值处理:删除、填充(均值、中位数、模型预测)或标记为特殊值,选择取决于业务含义与缺失机制。
- 异常值识别:基于统计阈值、业务规则或聚类方法发现离群点,区分“错误数据”与“真实的极端值”。
- 去重与一致性校验:消除重复记录,统一编码、单位与时间格式。
- 数据验证:检查数据类型、取值范围、外键关联与业务约束是否满足。
3. 数据转换与加工
清洗后的数据往往需要结构化重构,常见操作包括:字段拆分与合并、类型转换、标准化与归一化、聚合汇总、衍生指标计算、维度建模(如星型模型与宽表构建)。转换规则应以文档形式固定,避免“口头约定”导致口径漂移。
4. 数据整合
多源数据需要通过主键匹配、实体对齐与冲突消解进行融合。整合的难点通常不在技术,而在口径统一:同一指标在不同系统中可能定义不同,必须先完成指标治理,再谈物理整合。
5. 数据存储与输出
处理结果需要写入合适的位置:关系型数据库、数据仓库、数据湖或特征存储。输出环节应保证幂等性、可重跑性与版本可追溯,并配合质量校验与告警。
三、常见挑战与应对策略
数据质量不稳定是最普遍的挑战。应对之道是建立“质量规则库 + 自动校验 + 异常告警”的闭环,而不是依赖人工抽检。口径不一致则需要建立指标字典与数据血缘,明确每个字段的定义、来源与责任人。处理成本与时效的矛盾要求根据场景分层设计:报表类任务可跑批处理,实时风控类任务则需流式处理。隐私与合规要求对敏感字段进行脱敏、加密与访问控制,并在处理链路中留下审计记录。
重复处理与过度加工也值得警惕:不是清洗步骤越多越好,任何转换都可能引入偏差,应以“满足用途”为尺度,保留原始数据作为不可变的事实基准。
四、工具与流程实践
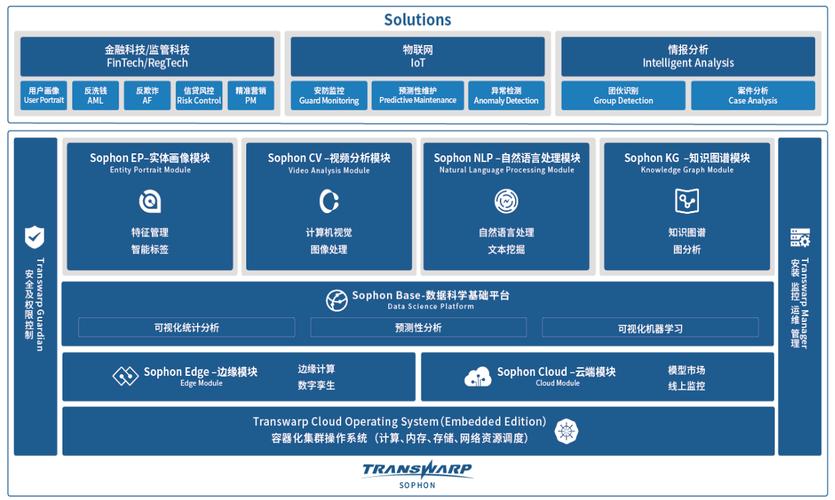
工具层面,Python(pandas、Polars)、SQL、Spark、Flink 以及各类 ETL/ELT 平台与调度系统构成了主流技术栈。但工具不是关键,流程规范才是。建议实践包括:
- 为每个处理任务编写可复现的脚本与配置,避免手工操作;
- 建立数据校验规则并纳入发布门禁;
- 维护数据血缘与元数据文档;
- 对处理结果做抽样比对与回归测试;
- 设置监控告警,及时发现空值率、行数突变与分布漂移。
五、从数据处理走向数据可信
数据处理的终点不是“跑通”,而是“可信”。一次成功的处理,应能让使用者清楚知道:数据来自哪里、经过了哪些变换、质量如何、适用什么场景。当数据处理具备可重复、可审计、可解释的特性时,它才真正成为组织决策的基础设施,而不是一次性的体力劳动。
归根结底,数据处理是一门关于严谨的工作:它要求我们既尊重数据的原始事实,也对每一次转换负责。把这一步做扎实,后面的分析与建模才能建立在稳固的地基之上。